
Summary
Tibero 역동기화는 Failover 이후 데이터 이력이 달라진 Old Primary를 현재 서비스를 처리하는 New Primary 기준으로 다시 맞춰 New Standby로 재구성하는 기능입니다.
전체 백업본으로 Standby를 처음부터 다시 구축하는 대신 기존 Data File을 활용하고, 필요한 블록만 New Primary에서 받아 차이를 정리합니다. 이를 통해 New Standby 재구성에 필요한 작업 부담을 줄이고, Standby 없이 운영되는 기간을 단축하는 데 목적이 있습니다.
다만 역동기화는 Old Primary에만 남아 있는 미전송 데이터를 되살리거나 두 데이터베이스의 변경 이력을 합치는 기능이 아닙니다. New Primary를 데이터의 기준으로 삼아 고가용성 구성을 복원하는 기능입니다.
Failover가 끝나도 고가용성 복구는 끝나지 않습니다
데이터베이스 장애가 발생하면 가장 먼저 해야 할 일은 무엇일까요? 바로 서비스를 빠르게 정상화하는 것입니다.
고가용성 환경에서는 주센터의 Old Primary에 장애가 발생했을 때, 재해복구(DR)센터에서 대기 중이던 Old Standby를 New Primary로 전환해 업무를 재개합니다.
운영자 입장에서는 우선 급한 불을 끈 셈입니다.
하지만 서비스가 재개됐다고 고가용성 구성이 원래 상태로 자동 복구되는 것은 아닙니다.
고가용성이란(High Availability)? 일부 시스템에 장애가 발생해도 다른 시스템이 서비스를 이어받아 업무 중단을 최소화하는 구성
장애가 발생했던 주센터의 Old Primary는 전환 전후의 데이터 상태가 달라질 수 있어 곧바로 New Standby로 사용할 수 없습니다.
결국 재구성이 끝날 때까지 DR센터의 New Primary는 New Standby 없이 단독으로 서비스를 처리하게 됩니다.
| 핵심 관점 Failover는 Old Standby가 New Primary로 전환되어 서비스를 재개하는 절차입니다. Old Primary를 New Standby로 재구성해야 고가용성 상태가 다시 확보됩니다. |
일반적으로는 전체 백업본을 이용해 New Standby를 다시 구축합니다.
그러나 데이터베이스가 클수록 백업본 전송, Data File 복원 및 Redo 반영에 시간이 오래 걸리며, 그동안 New Primary는 Standby 없이 운영됩니다.
Tibero 역동기화는 이러한 부담을 줄이기 위한 기능입니다.
전체 백업본으로 New Standby를 처음부터 재구축하는 대신, 현재 서비스를 처리하는 New Primary를 기준으로 Old Primary의 필요한 차이만 정리합니다. 기존 Data File을 활용해 New Standby 재구성에 필요한 작업량과 시간을 줄이는 데 목적이 있습니다.
Failover 이후 Old Primary를 바로 New Standby로 사용할 수 없는 이유부터 역동기화가 New Standby를 재구성하는 방식, 운영 시 고려사항 및 기능 검증 결과를 차례로 살펴보겠습니다.
본 아티클에서는 Failover 이전의 역할을 Old Primary와 Old Standby로 표기합니다. Failover로 서비스를 이어받은 Old Standby는 New Primary가 됩니다. 장애가 발생했던 Old Primary는 역동기화를 마친 뒤 New Standby가 됩니다.
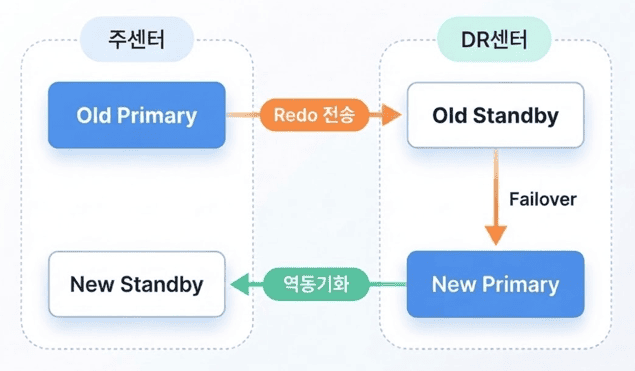
Failover로 Old Standby가 New Primary가 되며, Old Primary는 역동기화를 거쳐 New Standby로 재구성됩니다.
Failover 이후 Old Primary를 바로 사용할 수 없는 이유
ASYNC(비동기) 모드에서는 Old Primary가 트랜잭션을 완료하더라도 그 변경을 기록한 Redo가 Old Standby에 도착하기까지 시간 차이가 있을 수 있습니다. 이때 장애가 발생하면 Old Primary에는 있지만 Old Standby에는 전달되지 않은 변경 내용이 남을 수 있습니다.
이 상태에서 Failover가 수행되면 Old Standby는 전달받은 Redo를 기준으로 New Primary가 되어 새로운 트랜잭션을 처리합니다. 그 결과 Old Primary에만 남아 있던 변경과 New Primary에서 새롭게 발생한 변경으로 두 데이터베이스의 이력이 갈라집니다. 단순히 늦게 도착한 Redo를 추가로 반영하는 상황과는 다르기 때문에, Old Primary를 기동해 New Primary의 Redo를 적용하는 것만으로는 New Standby로 사용할 수 없습니다.
따라서 Old Primary를 New Standby로 사용하려면 New Primary를 기준으로 서로 달라진 블록과 Redo 이력을 먼저 정리해야 합니다. 이 작업을 수행하는 기능이 Tibero 역동기화입니다.
ASYNC는 이러한 차이가 발생하는 대표적인 사례입니다. SYNC 모드에서도 장애 시점과 구성에 따라 차이가 남을 수 있으므로, 전송 모드만으로 Old Primary의 재사용 가능 여부를 단정할 수는 없습니다.
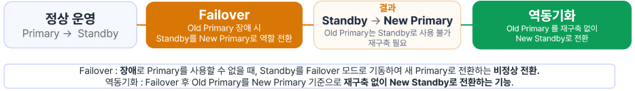
Tibero 역동기화란?
Tibero 역동기화는 Failover 이후 서로 달라진 두 데이터베이스를 다시 같은 기준으로 맞추는 기능입니다. 현재 서비스를 처리하는 New Primary를 기준으로 Old Primary의 차이를 정리해 New Standby로 재구성할 수 있는 상태를 만듭니다.
두 데이터베이스가 갈라진 시점을 기준으로 Old Primary에서 변경된 블록을 찾아 New Primary의 현재 블록으로 교체하고, 불필요한 Redo와 복구 기준 정보를 정리합니다. 이후 New Primary의 Redo를 수신·반영하는 후속 복구를 마치면 New Standby로 동작합니다. 두 데이터베이스의 변경 이력을 합치는 방식은 아니므로, Old Primary에만 남아 있던 미전송 변경 내용은 복구되지 않습니다.
| 역동기화는 Old Primary의 기존 파일을 활용해 New Standby 재구성 부담을 줄이는 기능입니다. |
왜 역동기화가 필요한가?
Failover 이후 고가용성 상태를 다시 확보하려면 New Primary를 기준으로 New Standby를 구성해야 합니다. 한 가지 방법은 백업본으로 전체 Data File을 복원하고 필요한 Redo를 반영하는 것입니다. 사용할 수 있는 백업과 복구 방식은 제품과 운영 구성에 따라 달라집니다.
전체 백업 기반 재구축은 Data File을 전송하고 복원해야 하므로, 데이터베이스가 클수록 작업 부담이 커집니다.
백업본을 이용한 재구축 외에도, Oracle Data Guard에서는 사전에 Flashback Database를 활성화하고 필요한 로그를 보관한 경우 기존 Primary를 Standby로 재구성할 수 있습니다.
Tibero 역동기화는 Old Primary의 기존 Data File과 Redo를 활용하고, 필요한 블록을 New Primary에서 받아 차이를 정리합니다. 따라서 전체 Data File을 다시 전송·복원하는 작업을 줄일 수 있고, 이 작업을 위해 별도의 Flashback Log를 사전에 생성·보관할 필요도 없습니다.
핵심 장점은 New Standby 재구성에 필요한 부담을 줄여 Standby가 없는 기간을 단축하는 데 있습니다.
역동기화 동작 방식(아키텍처)
Failover 이후에는 New Primary가 데이터의 기준이 됩니다. 역동기화는 먼저 두 데이터베이스의 Redo 일관성을 검사하고, Old Primary의 Failover RBA 이후 Redo에서 변경된 블록을 찾습니다. 해당 블록을 New Primary의 현재 블록으로 교체한 뒤, 이전 Redo와 복구 기준을 정리합니다. 주요 흐름은 다음 세 단계로 살펴볼 수 있습니다.
Phase 1 — 역동기화 조건 검사 (달라진 시점 확인)
먼저 New Primary와 Old Primary의 Redo 일관성을 확인합니다. Old Primary에 New Primary보다 앞선 Redo가 남아 있으면 일반적인 동기화를 진행할 수 없으며, 역동기화가 필요한 상황입니다.
Failover RBA(Redo Block Address)는 Failover 시 Old Standby가 디스크에 기록한 Redo의 마지막 위치를 나타내며, Redo Thread별로 Control File에 저장됩니다. 역동기화는 이 위치를 기준으로 차이를 찾습니다. New Primary에서 STANDBY_REVERSE_SYNC를 활성화하면 역동기화를 시작할 수 있습니다.
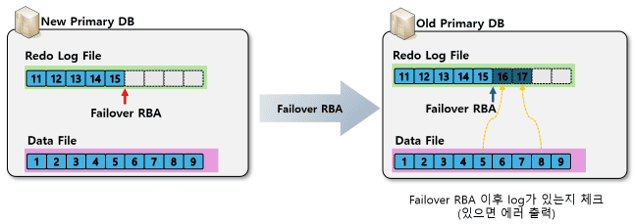
Phase 2 — 달라진 블록만 New Primary 기준으로 맞춥니다
New Primary는 Failover RBA를 Old Primary에 전달합니다. Old Primary는 이 위치 이후의 Redo를 읽어 변경된 데이터 블록의 <TSID, DBA> 목록을 만듭니다. TSID는 Tablespace 번호, DBA는 데이터 블록 주소입니다. 같은 블록을 반복해서 처리하지 않도록 중복을 제거합니다. 이때 Redo는 데이터를 다시 반영하기 위한 것이 아니라, 어떤 블록이 달라졌는지 찾는 데 사용합니다.
목록이 준비되면 Old Primary는 필요한 블록을 New Primary에 요청하고, 전달받은 현재 블록을 자신의 Data File에 덮어씁니다. Old Primary에만 남은 변경을 New Primary로 보내 합치는 과정은 아닙니다. 또한 전달받은 블록 중 최대 TSN을 Control File에 기록해, 후속 복구가 어디까지 진행되어야 하는지 관리합니다.
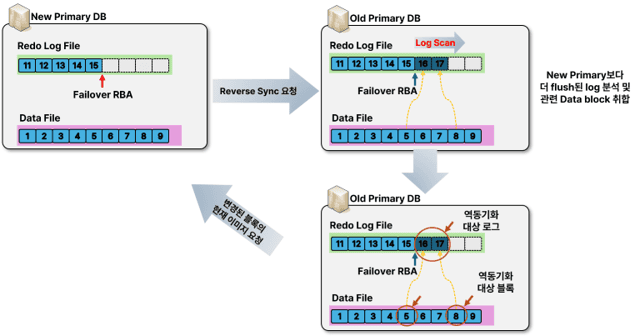
Phase 3 — Old Primary에 남은 이전 이력을 정리합니다
블록을 교체한 뒤에는 Old Primary의 Redo Thread별로 Failover RBA 이후의 이전 Redo를 정리합니다. 이어서 Checkpoint TSN/RBA 등 복구 기준 정보를 갱신하고 역동기화 대상 DB를 종료합니다. 이 단계까지 마치면 Old Primary는 New Primary의 Redo를 수신·반영하는 후속 복구를 수행할 준비가 됩니다.
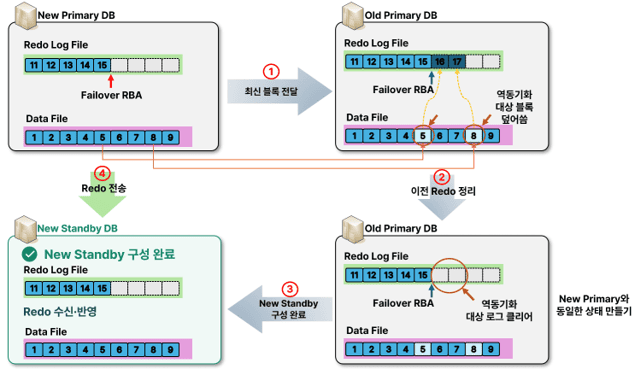
| 마지막 단계가 끝난 Old Primary는 아직 New Standby로 완전히 돌아온 상태가 아닙니다. New Primary에서 이후 발생한 Redo를 수신·반영해야 합니다. V$STANDBY에서 수신 및 복구 위치가 New Primary를 정상적으로 따라가는지 확인하면 New Standby 재구성이 완료됩니다. |
역동기화의 한계와 운영 시 고려사항
역동기화는 Failover 이후 New Standby를 재구성해 고가용성 상태를 다시 확보하는 기능이며, 장애 전 데이터 유실을 되돌리는 기능은 아닙니다. Failover 시점의 데이터 유실 범위는 Standby에 어디까지 Redo가 전송·반영됐는지에 따라 결정됩니다.
예를 들어 ASYNC 환경에서 장애 직전 Old Primary의 변경이 878번까지 Commit되었지만, Old Standby에는 787번까지만 전달되어 복구할 수 있다고 가정해 보겠습니다. New Primary는 787번까지를 기준으로 서비스를 재개하고 이후 새로운 트랜잭션을 처리합니다. 역동기화는 Old Primary에만 남은 788~878번의 변경을 합치지 않고, New Primary 기준으로 Old Primary를 맞춥니다. 따라서 해당 구간은 복구되지 않으며, Failover 이후 New Primary에서 발생한 변경은 후속 Redo 반영을 통해 New Standby에 반영됩니다.
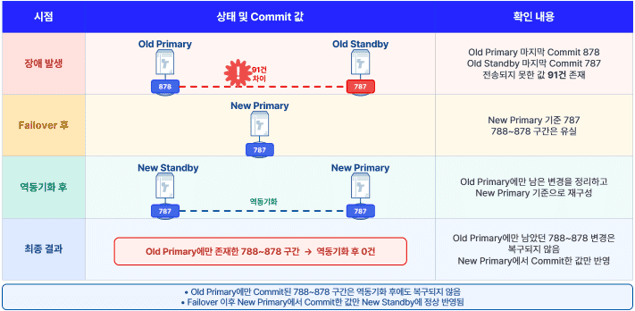
운영 적용 전에는 실제 데이터 규모와 Redo 발생량을 기준으로 소요 시간과 시스템 부하를 검증해야 합니다. 또한 작업 중단 시 전체 재구축으로 전환할 수 있도록 백업과 복구 절차를 함께 준비해야 합니다. 세부 지원 범위와 제한 조건은 Tibero 버전 및 Build에 따라 달라질 수 있으므로 적용 바이너리의 매뉴얼과 패치 정보를 확인해야 합니다.
| RPO 관점
RPO는 장애가 발생했을 때 허용할 수 있는 데이터 유실 범위를 의미합니다. |
기능 검증 결과 요약
기능 설명을 읽고 나면 자연스럽게 두 가지가 궁금해집니다. 실제로 Old Primary가 New Standby로 재구성되는지, 그리고 두 데이터베이스의 데이터가 같은지입니다. 이번 검증에서는 복잡한 수행 절차보다 이 두 질문에 답하는 핵심 결과를 확인했습니다.
New Standby 재구성과 데이터 정합성 검증
BenchmarkSQL로 Warehouse 300, 약 30 GB의 TPCC 데이터를 적재하면서 Old Primary에 역동기화를 수행했습니다. 이후 V$STANDBY에서 Redo 수신·복구 위치가 New Primary를 정상적으로 따라가는지 확인하고, 주요 TPCC 테이블의 Row Count와 실제 데이터 차이를 비교했습니다. 결과는 다음과 같습니다.
- New Primary와 New Standby의 주요 테이블 Row Count가 모두 일치했습니다.
- 각 테이블에서 New Primary MINUS New Standby와 New Standby MINUS New Primary를 양방향으로 수행한 결과, 차이 행이 모두 0건이었습니다.

| 정합성 결과
Row Count와 양방향 MINUS 결과를 함께 확인한 결과, 검증 대상 데이터가 New Primary 기준으로 New Standby에 정상 반영됐습니다. |
마치며
Failover로 서비스가 다시 시작되면 복구가 끝난 것처럼 보일 수 있습니다. 하지만 New Primary 혼자 서비스를 담당하는 동안에는 다음 장애를 받아 줄 New Standby가 없습니다. 서비스는 재개됐지만, 고가용성 복구는 아직 남아 있는 셈입니다.
Tibero 역동기화는 이 빈자리를 다시 채울 수 있는, Old Primary의 기존 파일을 활용해 New Standby를 재구성하는 기능입니다. 필요한 블록과 복구 기준을 New Primary에 맞추므로 전체 Data File을 다시 전송·복원하는 부담을 줄일 수 있습니다. 이 작업을 위해 Flashback Log를 별도로 생성·보관할 필요가 없다는 점도 장점입니다.
다만 New Primary에 전달되지 못한 데이터를 되살리는 기능은 아닙니다. 역동기화의 가치는 New Standby 재구성에 필요한 작업과 시간을 줄여, 다음 장애에 대비할 수 있는 고가용성 상태를 다시 확보하는 데 있습니다.
| 결론
역동기화는 New Standby 재구성에 필요한 작업과 시간을 줄여, Failover 이후 고가용성 상태를 다시 확보하도록 돕습니다. |
GTS: DB 운영의 골든타임을 지키는 기술지원 플랫폼
기업용 소프트웨어 기술지원의 변화: 문의 대응에서 운영 지식 플랫폼으로

No Comment! Be the first one.